เลือก AI ให้เหมาะกับงาน (สำหรับสถาปนิก)
ปัญหาหลักของสถาปนิกคือโครงการขาดทิศทาง และได้ข้อมูลช้าเกินไป AI ช่วยได้ทั้งสองเรื่อง แต่ต้องเลือกให้ถูกแบบ ทั้ง LLM, simulation และโมเดลที่เรียนจากข้อมูลของเราเอง
ปัญหาที่เป็นธรรมชาติของกระบวนการออกแบบของสถาปนิกคือ
- โครงการขาดทิศทาง ไม่ชัดว่าอยากไปทางไหน และจะวัดว่าแบบไหนดีกว่าด้วยอะไร ทางเลือกเลยเทียบกันไม่ได้ สุดท้ายตัดสินกันด้วยความชอบของลูกค้า ต้องทำแบบวนไปมา หรือไม่มีหลัก ไม่มีเกณฑ์หรือทิศทางให้ยึดเป็นตัววัด
- ได้ข้อมูลช้าเกินไป ผลวิเคราะห์เรื่อง performance หรือหลักเกณฑ์ตามข้อ 1 ไม่ว่าจะเรื่องแสง ความร้อน ลม วิว หรือแม้แต่ราคา มาช้าเกินไป มาถึงตอนที่แบบถูกตัดสินใจไปแล้ว กลายเป็นเพียงข้อมูลประกอบ ไม่ใช่ข้อมูลที่ทำให้แบบดีขึ้น เพราะข้อมูลไม่ได้อยู่ในกระบวนการตัดสินใจ
สองปัญหานี้ใช้ AI ช่วยแก้ได้ แต่ด้วยวิธีและ AI โมเดลที่ต่างกัน ปัญหาแรกเป็นงานของ LLM อย่าง ChatGPT, Gemini, Claude ส่วนปัญหาที่สองต้องใช้การทดสอบ การจำลอง การวัดผลและโมเดลที่เรียนจากข้อมูลของเราเอง
AI ไม่ได้มีแค่แชทบอท
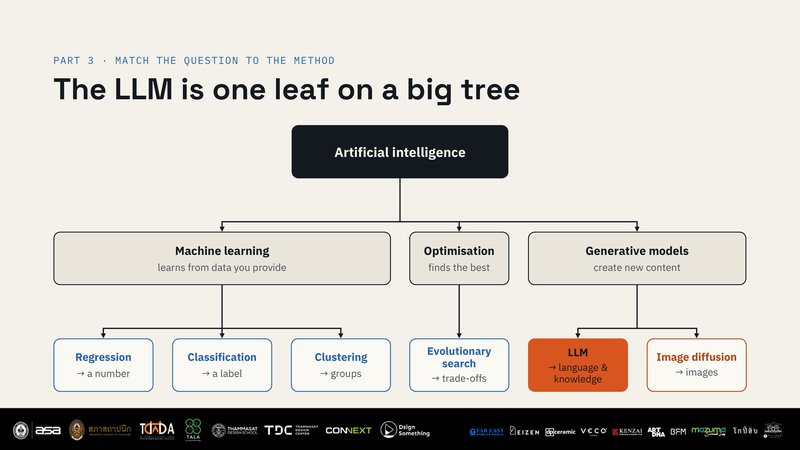
พอพูดถึง AI คนส่วนใหญ่นึกถึง ChatGPT, Gemini, Copilot หรือ Midjourney ทั้งหมดเป็น AI ด้านภาษาและภาพ ซึ่งเป็นแค่กิ่งเดียวของ AI ทั้งหมด ถ้ารู้จักแค่กิ่งนี้ ก็จะเอาไปใช้กับทุกปัญหา เช่น ถามแชทบอทว่าห้องนี้จะร้อนแค่ไหน ทั้งที่มันมีวิธีที่เหมาะสมกว่า
--
ให้ AI อยู่ในกระบวนการออกแบบ
กระบวนการออกแบบมักมี Flow ประมาณนี้: ตั้งสมมติฐาน → ทดสอบ → ดูผล → ปรับ ยิ่งวนได้มากตั้งแต่ช่วง concept ยิ่งพัฒนาได้แบบได้ดี
แต่ถ้าขาดทิศทาง วนไปก็ไม่รู้ว่าจะวัดอะไร อาจจะ render ดูความสวยงามได้อย่างเดียว ได้ข้อมูลช้า ลูปก็หมุนได้ไม่กี่รอบก่อนถึงเวลาตัดสินใจ บางทีได้ลองแค่ 3 ทางเลือก แทนที่จะเป็น 300
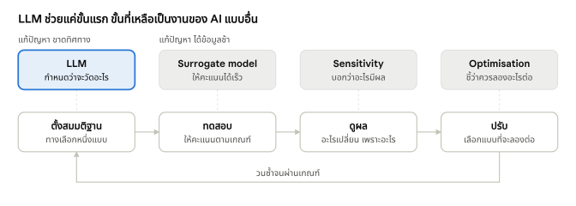
LLM ช่วยให้มีทิศทางตั้งแต่ต้น ส่วนความเร็วและการอ่านผลมาจาก AI ที่เรียนจากข้อมูลของเรา
--
ปัญหาที่ 1 ขาดทิศทาง: ใช้ LLM แปลงเป้าหมายให้เป็นตัวเลข
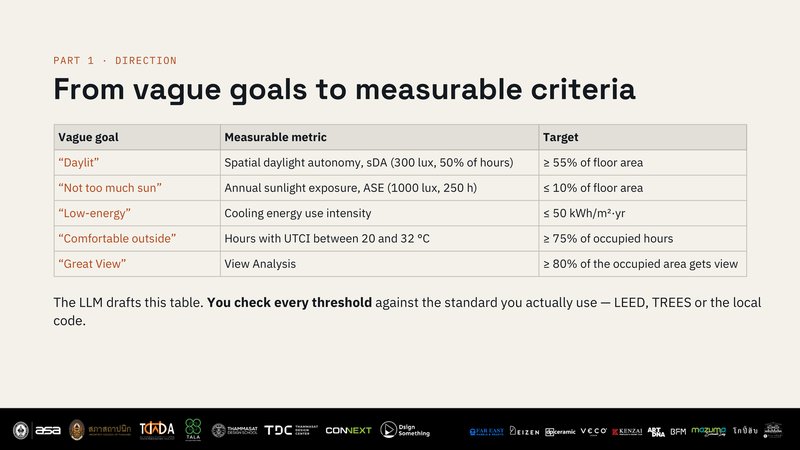
ช่วงต้นโครงการ LLM ช่วยได้ดีที่สุด คือแตก brief หามาตรฐาน และเปลี่ยนคำอย่าง "อยากให้สว่าง" ให้เป็นตัวเลขที่ทดสอบได้ พอมีตัวเลข ทุกทางเลือกก็เทียบกันด้วยไม้บรรทัดเดียวกัน
--
แต่ LLM ผิดได้อย่างมั่นใจ ที่เจอบ่อยมี 3 แบบ
- อ้างข้อกำหนดหรืองานวิจัยที่ไม่มีอยู่จริง
- อ้างมาตรฐานเวอร์ชันเก่า
- ให้ตัวเลขชัดเจน โดยไม่มีที่มา
วิธีคือ LLM เสนอ เราตรวจแหล่งที่มา แล้วจึงใช้ทดสอบ
ปัญหาที่ 2 ได้ข้อมูลช้า: ใช้ simulation กับ surrogate model
ข้อมูลเรื่องแสง ความร้อน และลม ได้มาจาก simulation ซึ่งแต่ละครั้งใช้เวลา หลายโครงการเลยรอให้แบบนิ่งก่อนค่อยรัน พอผลกลับมา การตัดสินใจสำคัญก็ผ่านไปแล้ว
Grasshopper ทำให้แบบหนึ่งแบบกลายเป็นหลายพันแบบ เพราะทุกอย่างผูกกับ slider เช่น ขนาดหน้าต่าง ความลึกแผงบังแดด การหมุนอาคาร ขยับ slider ก็ได้แบบใหม่ทันที
แต่ละวิธีการวัดผลใช้เวลาต่างกัน ขึ้นกับขนาดโมเดลและการตั้งค่า ช่วง concept เรามีเวลาเพียงไม่กี่ week บางทีไม่กี่วัน การทดสอบที่ช้าเลยถูกข้ามไป ที่เราชอบบอกกันว่า "เอาไว้ทำโครงการหน้า"
| การทดสอบ | เครื่องมือ | ต่อ 1 ครั้ง | 300 design options |
|---|---|---|---|
| แดดที่สาดลงผิวอาคาร | Ladybug | วินาที | นาที |
| แสงธรรมชาติ | Honeybee + Radiance | นาที | ชั่วโมง |
| พลังงาน | Honeybee + EnergyPlus | นาที หรือชั่วโมง | ชั่วโมง |
| ลม | Eddy3D + OpenFOAM | ชั่วโมง | สัปดาห์ |
ทางแก้คือ surrogate model รัน simulation จริงไว้หลายร้อยครั้ง แล้วเทรนโมเดลให้เรียนความสัมพันธ์ระหว่าง slider กับผลลัพธ์ หลังจากนั้นโมเดลตอบได้ในเสี้ยววินาที คล้ายวิศวกรที่เห็นเคสมาเยอะจนประเมินได้ทันทีว่าแบบไหนน่าจะร้อน
พอเหลือตัวเลือกสุดท้ายไม่กี่แบบ ค่อยรัน simulation จริงตรวจซ้ำ เพราะ surrogate เป็นค่าประมาณ ทั้งกระบวนการใช้ simulation จริงราว 300–400 ครั้ง แทนหลักพันครั้งถ้าให้ optimiser รัน simulation ตรงๆ
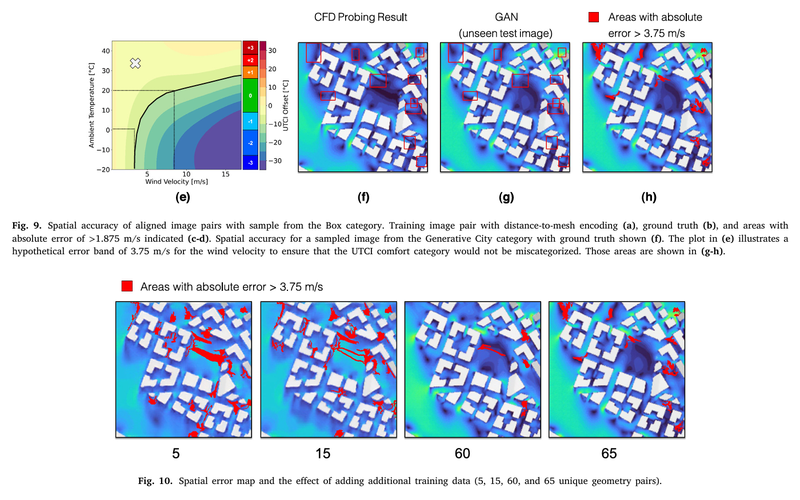
วิธีนี้เป็นวิธีที่ได้รับความนิยม ยกตัวอย่างงานวิจัย AGAN-Based SurrogateModel for Instantaneous UrbanWindFlow Prediction ในปี 2023 โดย Patrick Kastner∗, Timur Dogan ที่ทำเรื่องลม จาก GANs (GANs เป็นชื่อสถาปัตยกรรมของโมเดล AI ประเภทหนึ่ง สามารถสร้างภาพได้ แต่ใช้คนละวิธีกับการสร้างภาพแบบปัจจุบันด้วยโมเดลอย่าง Nano-Banana หรือ Astra)
--
งานอื่นๆ: เลือก AI จากหน้าตาของคำตอบ
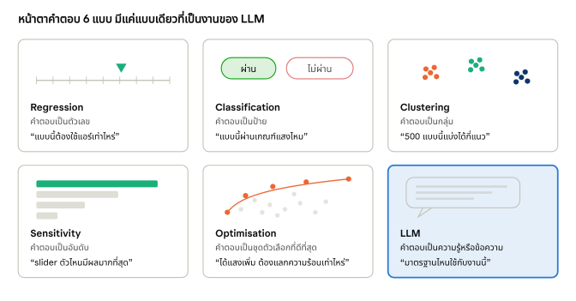
นอกจากสองปัญหานี้ งานอื่นก็ใช้หลักเดียวกัน คือถามก่อนว่า "คำตอบที่อยากได้ หน้าตาเป็นแบบไหน" แต่ละแบบมีเครื่องมือที่เหมาะของมัน
--
เทียบกับเรื่องใกล้ตัว
- Regression (ทำนายตัวเลข) เหมือนประเมินราคาคอนโดจากขนาดและทำเล ในงานออกแบบใช้ทายว่าแบบนี้ต้องใช้พลังงานทำความเย็นเท่าไหร่
- Classification (แปะป้าย) เหมือนระบบคัด spam ในอีเมล ในงานออกแบบใช้ช่วยทำนายประเภทหรือจำแนกว่าห้องนี้ควรจะเป็นอะไร หรือห้องนี้จะมีแสงธรรมชาติเพียงพอหรือไม่
- Clustering (จัดกลุ่ม) เหมือนแยกเสื้อผ้ากองใหญ่เป็นกองๆ ตามความคล้าย โดยไม่มีใครบอกหมวดล่วงหน้า ใช้ย่อ 500 ทางเลือกให้เหลือไม่กี่กลุ่มไปคุยกับลูกค้า
- Sensitivity (จัดอันดับ) เหมือนรู้ว่าแกงเค็มเพราะน้ำปลา ไม่ใช่เพราะน้ำเปล่า ใช้บอกว่าตัวแปรไหนในงานออกแบบไหนมีผลจริง ตัวไหนไม่ต้องเสียเวลาถกกัน
- Optimisation (ชุดตัวเลือกที่ดีที่สุด) เหมือนซื้อรถที่ต้องแลกระหว่างราคากับความประหยัด ไม่มีคันเดียวที่ดีที่สุด มีแต่ชุดที่ดีที่สุดในแต่ละการแลก ใช้ดูว่าได้แสงเพิ่ม ต้องแลกกับความร้อนเท่าไหร่
- LLM (ความรู้และภาษา) ใช้เมื่อคำตอบอยู่ในหนังสือ มาตรฐาน หรืองานเขียน ไม่ใช่ในแบบของเรา
Regression กับ classification อยู่ในตระกูลเดียวกันที่เรียกว่า prediction คือเรียนจากตัวอย่างที่มีคำตอบแล้ว แล้วทายคำตอบให้แบบใหม่
--
Generative กับ Predictive ต่างกันตรงไหน
AI สร้างภาพหรือข้อความ (generative) ตอบคำถามว่า "หน้าตาเป็นไปได้แบบไหน" มันเรียนจากข้อมูลมหาศาลของทุกคน ผลลัพธ์จึงออกมากลางๆ และถามซ้ำมักได้คำตอบใหม่
AI แบบ predictive ตอบคำถามว่า "ทีมเราจะทำแบบไหน" มันเรียนจากงานเก่าของเราเอง ใส่ข้อมูลเดิมได้คำตอบเดิม และวัดได้ว่าคลาดเคลื่อนเท่าไหร่
ทั้งสองแบบเรียนด้วยการทำนายเหมือนกัน (LLM ก็คือการทายคำถัดไป) สิ่งที่ต่างคือผลลัพธ์ที่ได้ และข้อมูลของใครที่มันเรียนมา
ในการบรรยายผมสาธิต add-in ใน AutoCAD ที่วาดกรอบห้องชุดแล้วได้ผังห้องตามแบบที่สถาปนิกคนหนึ่งจะวาด กรอบเดียวกัน เทรนด้วยข้อมูลของสถาปนิกคนละคน ก็ได้ผังคนละแบบ (เดโมใช้ข้อมูลจำลอง) ผมได้แจกวิธีทำคร่าวๆไปให้ด้วยสำหรับคนที่สนใจ และผมจะบอกก่อนเลยว่า ความยากไม่ได้อยู่ที่เทคโลยี ความยากอยู่ที่การจัดการข้อมูลมาเทรนมัน
ซึ่งแน่นอนว่าเป็นหนึ่งใน Service ที่ผมช่วยบริษัทออกแบบทำ สนใจจ้างได้ แฮ่! ขายของ
--
คำถามเดียวที่ควรถามก่อนใช้ AI
กลับมาที่สองปัญหาตอนต้น โครงการขาดทิศทาง ใช้ LLM ช่วยตั้งเกณฑ์แล้วตรวจแหล่งที่มา ได้ข้อมูลช้า ใช้ simulation กับโมเดลที่เทรนจากข้อมูลของเรา ส่วนงานอื่น ให้ถามคำถามนี้ก่อน
คำตอบที่ต้องการ ขึ้นอยู่กับความรู้ทั่วไป หรือข้อมูลและฟิสิกส์ของงานเราเอง?
- ความรู้ทั่วไป เช่น มาตรฐาน กรณีศึกษา การเขียน brief → ใช้ LLM แล้วตรวจแหล่งที่มา
- ข้อมูลและฟิสิกส์ของงานเรา เช่น แสง ความร้อน ลม ผังที่ทีมเคยทำ → ใช้ simulation และวิธีที่เรียนจากข้อมูลของเรา ส่วนโมเดลที่เทรนเองใช้เมื่อ simulation ช้าเกินกว่าจะถามบ่อยๆ
--
สรุป
ที่ผมมาเขียนอันนี้อีกรอบ เพราะว่าหลังจากงาน AI Designer Day เมื่อวันศุกร์ที่ผ่านมา มีคนมาบอกผมว่าฟังไม่รู้เรื่อง ฟังไม่เข้าใจ เลยมาทำโพสนี้อีกรอบ เพื่อให้ผู้เข้าร่วมได้ทบทวนครับ